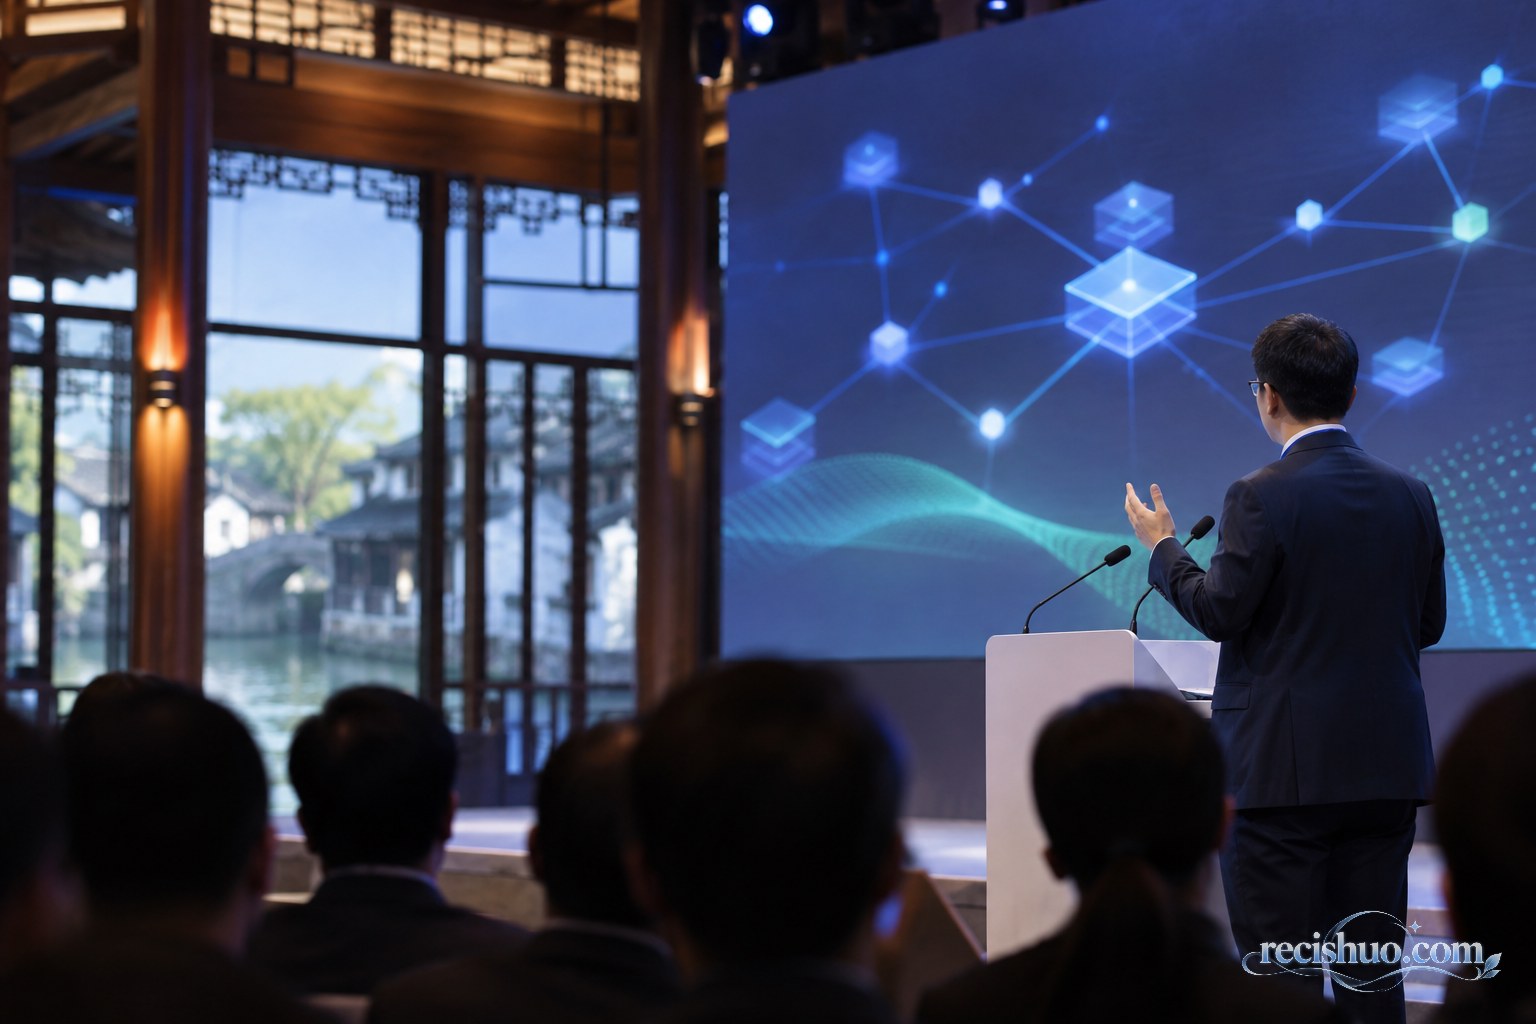
11月3日,2026年世界互联网大会乌镇峰会在浙江乌镇召开。阿里巴巴集团联合创始人及董事会主席蔡崇信在演讲中谈及人工智能开源模型的发展,并表达了一个明确判断:开源有助于普及人工智能。
这句话的重点,并不只是模型能否免费下载,而是人工智能的研发与使用门槛能否降低,更多开发者和企业能否参与改进,技术又能否真正进入行业场景。理解“开源促进普及”,需要同时看到机会、成本和治理边界。
开源模型为什么可能加快人工智能普及
第一层:让更多人获得研究和试用入口
如果模型的代码、参数或相关技术资料以一定方式开放,开发者便可能在许可范围内研究其结构、测试能力,并根据自身需求进行调整。对于高校团队、中小企业和独立开发者而言,这种入口十分重要:他们不必完全从零训练模型,也不必只能通过封闭服务验证想法。
开放程度并非只有“全开”与“全关”两种状态。现实中,模型可能仅开放代码,也可能提供参数、技术报告或部分训练工具;不同许可证对商用、修改和再发布的规定也不相同。因此,判断一个模型是否真正降低了门槛,不能只看“开源”标签,还要阅读许可条款与使用条件。
第二层:缩短从通用能力到行业工具的距离
通用模型具备基础能力,但医疗、制造、教育、零售等场景通常还有专业术语、业务流程和数据安全要求。开放模型给了使用者进一步适配的空间,例如在合规前提下进行微调、压缩模型,或将其部署在组织可控的环境中。
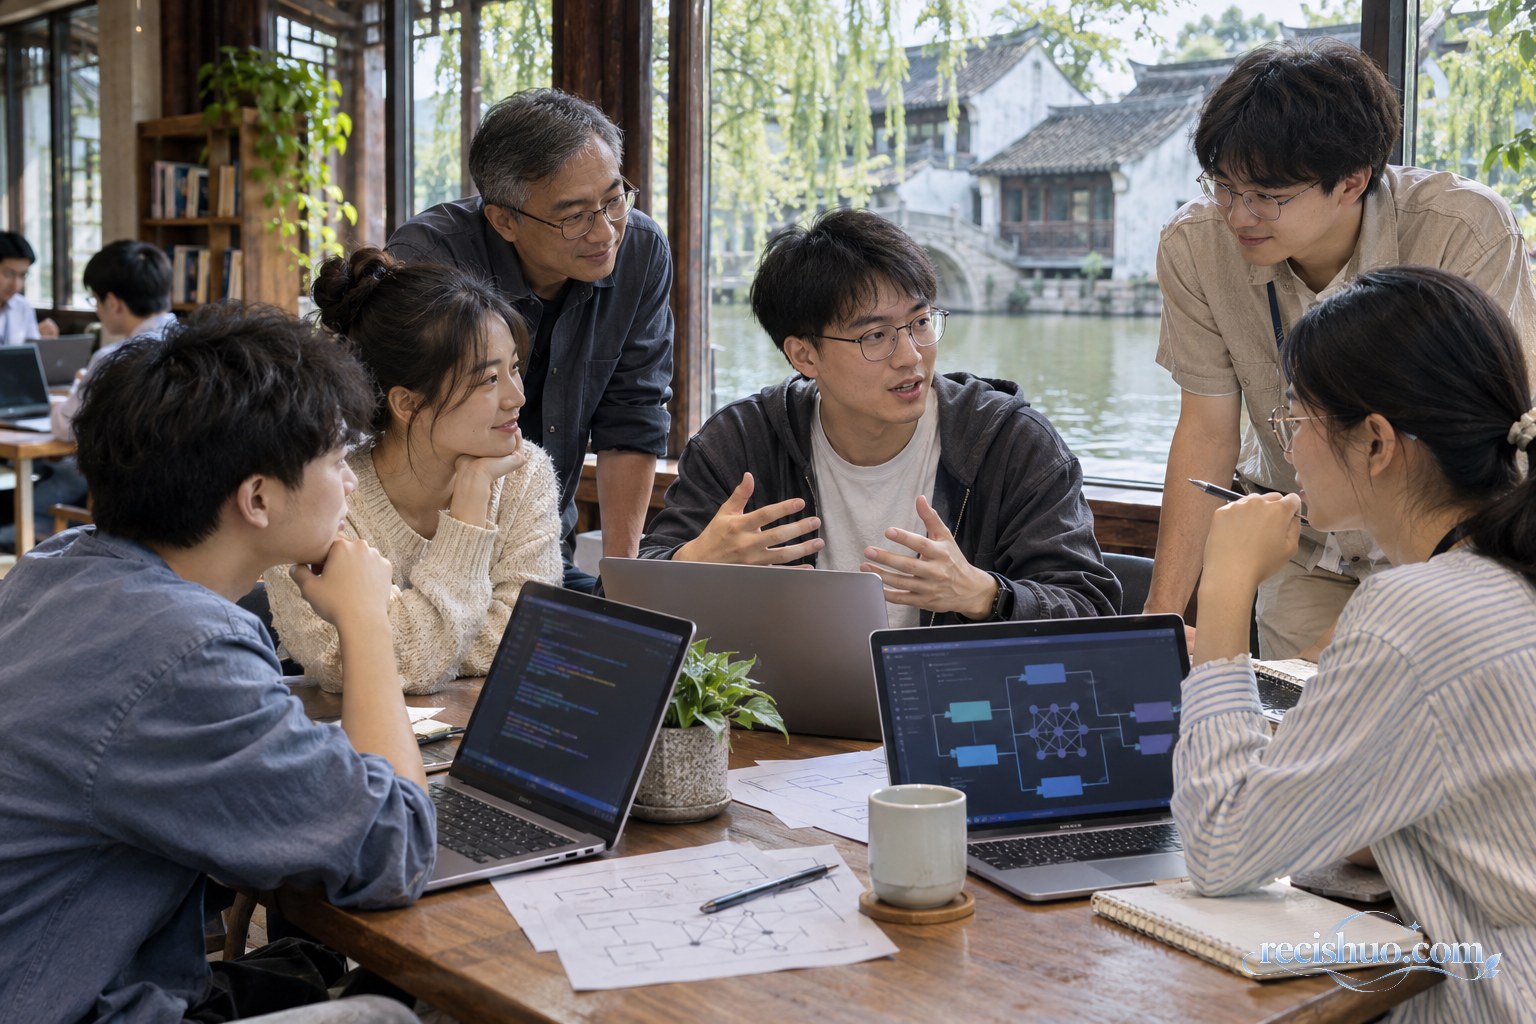
这也意味着,人工智能创新不再完全依赖少数基础模型提供者。开发者可以围绕同一底座制作工具、插件和行业方案,使用者的反馈又可能推动模型继续改进。开源由此形成一种协作机制,而不仅是一种文件分发方式。
第三层:给企业更多成本与部署选择
使用开放模型,企业可能拥有本地部署、选择算力平台和调整模型规模的空间。这种灵活性有助于控制长期成本,也便于处理对数据流向较为敏感的任务。不过,“可以自行部署”不等于“部署没有成本”:服务器、工程团队、模型评测、安全维护和版本升级都需要持续投入。
企业若只比较模型的调用价格,很容易低估总成本。更实用的算法是把算力、人员、数据治理、故障处理和合规审查放在同一张表里,再与商业闭源服务比较。此前关于人工智能投资过度集中及其潜在风险的讨论,也提示市场不能只关注投入规模,还应观察资源是否转化为有效应用。
开源不等于免费,也不等于没有限制
“开源有助于普及”是一种关于发展路径的判断,并不能推导出所有开放模型都能被任意使用。读者在接触具体产品时,至少要核对四项内容:
- 开放范围:究竟开放了代码、模型参数、训练方法,还是只提供在线接口。
- 许可条件:是否允许商业使用、二次修改和再发布,对用户规模或应用领域有无约束。
- 运行成本:本地部署所需的硬件、能源和运维能力是否超出实际预算。
- 数据责任:输入内容是否包含个人信息、商业秘密或受监管数据,相关处理是否合规。
因此,开源带来的首先是选择权与研究入口,而不是自动消除全部成本。模型文件能够获得,不代表普通电脑一定能够流畅运行;允许修改,也不代表修改后的系统天然准确、安全。
开放越广,为什么越需要治理能力
技术被更多人采用后,错误输出、隐私泄露、内容滥用和供应链安全等问题也会更加具体。开源与治理并非对立关系。恰恰因为参与者更多,模型说明、风险评测、版本记录、漏洞响应和使用规范才更重要。
对模型提供方而言,需要尽可能说明适用范围与已知局限;对二次开发者而言,应对新增数据、插件和功能进行测试;对使用单位而言,则要明确谁能够访问模型、哪些内容不得输入、输出结果由谁复核。责任不能因为底层模型开放而消失。
此外,基础模型、算力和资本集中度仍值得持续观察。开源能够扩大参与面,却未必自然解决算力昂贵、优质数据稀缺等问题。观察产业发展时,也可结合短期市场波动与企业长期价值的区别,避免仅凭一个技术概念或一次市场反应判断行业前景。
企业和普通用户可以怎样判断实际价值
企业先做小范围验证
- 明确要解决的具体问题,例如知识检索、客服辅助或文档整理,不以“必须使用AI”作为目标。
- 准备可量化的测试集,比较准确率、响应速度、人工复核时间与总成本。
- 审查许可证、数据来源和部署环境,确认商用与数据处理边界。
- 保留人工审核与退出方案,避免业务流程对单一模型形成不可逆依赖。
普通用户不要把“开放”误读成“可靠”
开源模型的回答仍可能存在遗漏或错误。涉及医疗、法律、金融和人身安全等高风险事项时,不应把模型输出直接当作专业结论。下载模型或第三方应用时,还应核对发布渠道、开发者信息和所需权限,避免安装来源不明的文件。
这场讨论真正值得关注什么
蔡崇信在乌镇峰会谈AI开源,触及的是人工智能如何从少数机构的前沿能力,逐渐变成更多组织可以理解、调整和使用的工具。开源的价值在于扩大入口、促进协作并增加部署选择;它的局限则在于算力、数据、专业人才和安全责任不会随之自动消失。
评价人工智能是否真正普及,不妨观察三个结果:普通开发者能否合理使用,中小企业能否承担完整成本,最终产品能否稳定解决真实问题。只有开放能力与治理机制共同成熟,技术普及才不只是参与者数量增加,更是可靠、可持续的应用增长。
版权声明:本文由热词说编辑撰写,未经授权请勿转载。撰写日期:2026年11月3日。
本站编辑原创,发布日期:2026年11月03日 20时05分27秒(北京时间)